DISCLAIMER : Cet article a été écrit sans Intelligence Artififielle (et probablement également sans beaucoup d’Intelligence tout court, mais au moins bien humaine). Donc si les tirets longs vous manquent, demandez à votre LLM préféré de vous en faire un résumé/rephrasage. (Une seule image a été générée par IA, petit jeu : devinez laquelle)
TL:DR : L’auteur prend beaucoup de détours et fait des takes questionnables pour dire qu’il a eu l’idée de faire une plateforme de TAAAS après avoir fait une blague, tout était déjà dans le titre
Bonjour à toutes et tous, aujourd’hui je vais vous raconter comment j’ai fait une petite farce à un lead dev, puis ça m’a donné envie de développer la plateforme d’automatisation de tests Yesbot.
Le contexte
En 2018 je travaille comme développeur Fullstack Java (Spring + Thymeleaf) intermédiaire pour une société d’État chargée de l’exploitation des parcs naturels du Québec. Une super bonne équipe, du moins jusqu’à un moment qui coïncide avec l’arrivée d’un certain manager, (on en parlera dans un autre article… peut-être). On était 4 développeurs : 2 full-stack intermédiaires spécialistes Java, un lead senior également architecte, et une dev front-end. On s’entendait bien et tout allait bien, mais il fallait faire beaucoup de tests, et également en écrire beaucoup lorsqu’on créait de nouvelles fonctionnalités.
Juste pour le fun, qui ici aime développer de nouvelles fonctionnalités sur un projet ?
Maintenant qui aime faire des tests et écrire des tests sur ces nouvelles fonctionnalités, ou sur les plus anciennes ?
(J’avais prévu de me barrer s’il y avait eu plus de mains levées.)
Mais ce n’est pas étonnant : au fond, on est des bâtisseurs, on aime voir les choses concrètes émerger de notre clavier/souris et de notre sueur de front. On se sent valorisés quand on on montre un truc au PO qu’il ou elle ne pensait pas possible (ou bien on lui avait dit que ça prendrait beaucoup plus d’efforts à faire). Heck, même les non-développeurs (les vibe-codeurs) aiment ça.
Donc pour revenir à mon histoire, on avait une bonne quantité de tests, et à tous les étages de la pyramide
Sauf les tests UI (ou end-to-end si tu veux), mais genre vous avez des tests UI actifs qui roulent avant chaque build, vous ?
Alors, évidemment il fallait constamment en écrire de nouveaux à chaque nouvelle fonctionnalité, ainsi qu’à la découverte de bugs, ou juste lorsqu’on voyait qu’on avait des manques (on avait pas de guard de commit sur la couverture). C’était fastidieux, notamment pour nos tests d’API, car on devait avoir des objets complexes dans les données de provionnement des tests. Ça prenait un temps fou non seulement pour en écrire de nouveaux, mais également pour débugguer ceux qui existaient, ou ceux qui brisaient suite à des changements de contrat ou de modèle de données. Et je ne vous parle pas des cauchemardesques et fameuses tâches de “refactoring des tests” dont j’ai encore dees flashbacks aujourd’hui. Mais bon, comme on se le disait : pas le choix de faire ce travail ingrat. Just git good at it.
Alors j’ai eu une idée un peu bête :
L’annotation @Autotest
Imaginez une annotation que l’on met sur les méthodes d’endpoint des controlleurs REST qu’on voudrait tester, ou bien sur les classes des controlleurs elles-mêmes. Elle générerait automatiquement les tests d’API associés sans avoir à écrire une seule ligne de code ni se casser la tête à créer les objets de test à envoyer ou renvoyer.
J’ai imaginé à l’arrache plusieurs mécanismes par lesquels on pourrait faire ça de façon plus ou moins crédible, comme si j’avais lu la doc de cette librairie fictive open-source. Ensuite j’ai ajouté cette fausse annotation dans le code de ma branche de développement, pour faire comme si j’avais testé cette solution afin de couvrir mes développements actuels. Le code compilait, alors j’ai appelé le lead dev de l’équipe pour lui montrer.
«- Wow mais c’est génial ça ! me dit-il tout excité par cette découverte. Je me souviens encore de l’expression sur son visage d’étonnement et d’enthousiasme non feint.
– Oui ! Comme ça plus besoin d’écrire le moindre test d’API avec ça, on met juste @Autotest partout dans nos controlleurs REST et la lib s’occupe du reste !»
Bon évidemment comme je suis pas très bon pour faire durer les blagues j’ai vite révélé le pot-aux roses, et il est reparti un peu déçu à sa pause dej pour ensuite ne plus jamais y repenser. Mais moi je suis resté avec un germe d’idée, et deux constats :
Premier constat : j’aime pas écrire des tests
(Bravo à vous si vous l’aviez deviné)
Évidemment tout le monde connait l’importance de faire de tests. Personne de sain d’esprit et d’intelligent ne le nie. Mais je sais pas, perso écrire et débugguer du code de tests, ça me soûle, je trouve ça répétitif et peu créatif. Typiquement c’est genre de code qui ne va vous rapporter que des reproches quand il buggue ou quand il est manquant : personne ne va jamais venir vous féliciter pour la beauté et l’élégance de votre code de test.
Deuxième constat : Automatiser la création de code de tests c’est peut-être bien
OK, je vous vois venir : «T’as juste à prendre ton LLM le plus chatoyant et générer ton code de tests, on en parle plus merci bonsoir»
Alors, pour commencer, je ne vais absolument pas écrire ici que
L’IA produit du mauvais code de tests
Parce que ce serait en grande partie faux.
Le problème que l’IA pose est un peu plus subtil que ça, et ça mériterait probalement un article en soit (article que je ne vais pas promettre sauf si quelqu’un me paie pour l’écrire)
Aujourd’hui, la plupart des modèles sont capables de lire votre de base de code, en particulier vos endpoints, votre modèle, et générer du code de test sans problème. Mais ces tests correspondent-ils vraiment à quelque chose ?
En gros, le problème c’est que parfois, (ie. pour tout ce qui dépasse une opéraiton atomique) les use cases de test sont complexes, et l’IA n’a pas de notion de l’ordre dans lequel les endpoints sont appelés. Ce qui signifie que le code de tests généré va rouler, passer ou pas, mais comme il est généré à partir d’une analyse statique du code, il n’a pas l’information de cet enchainement d’appels, ainsi que la signification des données passées à chaque étape. Il doit donc l’inventer, ou bien vous devez le lui décrire en détail. Ce qui revient quasiment à écrire vous-même les tests.
C’est déjà une tâche suffisement difficile pour les humains. Souvent cela nécessite une certaine quanité et qualité d’expertise métier et de connaissance du code. Et également du temps pour créer et maintenir ces tests. C’est pour ça qu’on a des QA, qui sont souvent également aussi des devs.
Ensuite,
Le code de test n’est pas un capital technique
Entre nous, vous en avez pas marre de reviewer des PRs dont plus des trois quarts du code est du code de tests ? Du code qui va briser lors de la moindre modification (c’est d’ailleurs son rôle ! Sinon ça veut dire qu’il ne couvre pas votre code). Et une fois brisé vous allez juste demander à l’IA «fixe le code de tests steuplé (et ne te trompe pas)».
Si le code de test doit changer à chaque fois que votre code applicatif est modifié, est-il fonctionnellement différent du code compilé ? Est-ce que ça ne lui confère pas de fait un rôle de code sattellite, intrinsèquement jetable ?
Donc je vous demande : à quoi sert le code de test ?
Le besoin d’avoir du code de tests vient fondamentalement de la difficulté à prévoir l’ensemble des effets du code, et de s’assurer que ces effets correspondent à ce qui est attendu. C’est un besoin légitime, car on veut pouvoir détecter les manques (les effets qu’on voudrait voir advenir mais qui n’adviennent pas), et les bugs (des effets qui adviennent alors qu’on voudrait qu’ils n’adviennent pas, ou bien des effets qui n’adviennent pas de la façon exacte qu’on voudrait qu’ils adviennent). En théorie les tests permettent de détecter ces cas, mais c’est dans la pratique que l’enfer se cache. Gardez ça en tête, on y reviendra plus tard.
La façon dont je vois le code de tests actuellement, (attention, métaphore foireuse en approche) c’est un peu comme je vois les rails de, les garde-corps, barrières et autres structures de protection sur les constructions de circulation de véhicules et de personnes. Elles sont là pour protéger, limiter, et contraindre la circulation, mais elles n’ont pas de raison d’être sans la route, l’escalier ou le chemin qu’elles accompagnent. Il serait bizarre de dire qu’une maison doit être construire à partir des plans de ses structures de protection, et que celles-ci constituent l’ensemble du plan de la maison. Pourtant c’est ce qu’on nos a habitués de penser dans le développement logiciel.
Les tests ne sont pas non plus des spécifications
Enfin, et c’est la take de cet article qui va m’attirer les foudres des vendeurs de formations et autres séminaristes en TDD : les tests sont la façon la plus dégueulasse d’écrire des spécifications.
Je suis un programmeur. Je suis habitué à décrire les choses de façon positive (ou additive), c’est-à-dire expliquer mon intention en partant du happy path, puis en allant vers les edge cases. Je ne suis pas un QA, qui me donnent l’impression de raisonner dans l’autre sens, c’est–à-dire (et vous me contredirez), en partant des edge cases, pour sécuriser ensuite le happy path. Dans cette logique, pour moi, étrange, il est normal de partir des tests, pour soustraire les edge cases afin de définir ainsi le comportement du code que lon veut tout en étant assuré que tout le code est couvert. Pour moi ces deux approches sont aussi différentes que le sont la scupture par modelage que celle par taille. Sauf que dans le cas du code on reporte la significance vers le code de tests, le code devient sattelitaire, jetable. Mais je ne suis pas un QA ! Je ne raisonne pas de cette façon. Je pense que le pêcher originel du TDD/BDD/XDD est précisément ce renversement d’expertise. De mon point de vue, c’est pas loin du bullying,
On peut me reprocher que ceci est un argument purement esthétique, et que le code de tests est nécessaire d’une façon ou d’une autre, et je ne nie ni l’un ni l’autre. Sauf que j’ajouterais qu’il est normal d’avoir beaucoup plus de code de test pour décrire une comportement de façon soustractive que dans l’autre sens, donc ça devient également un argument d’éfficience. Car la quantité de code vient avec un coût. Et quand au fait de tester de la façon la plus exhaustive possible, je pense qu’il faut toujours le faire, mais qu’on est fondamentalement pas obligés de lier ce code à la base de code applicatif. Pour ce faire il faudrait, selon moi,
Virer les tests de la base de code
Franchement, perso j’en peux plus des PRs où plus de la moitié du code c’est du code de tests. Sans compter que c’est du code jetable : on sait que le LLM va le changer automatiquement dès que quoi que ce soit aura changé dans le vrai code.
Je suis toujours effaré qu’on trouve collectivement normal que la moitié (si ce n’est plus) du code versionné est juste du code de test. Je comprends qu’il est pratique d’avoir le même language et les mêmes technos pour rouler une application et la tester à bas-niveau, si on se concentre sur les entrées-sorties de haut niveau, cette exigeance disparait. En d’autres termes on se contraint à utiliser les outils fournis avec le language de programmation choisi pour l’application, tant qu’on part du principe qu’on doit écrire la majorité de nos tests à bas niveau.
Finalement, il faut parler rapidement du coût de maintenance du code de tests. Même si tout est géré avec des LLMs, cela reste une charge cognitive, ne serait-ce que pour relire ces fameuses PRs de l’enfer qui ne devraient jamais exister intitulées “refactoring du code de tests”. (Si vous n’avez jamais vu de telles choses, par pitié, protégez votre innocence). Le code qu’il soit généré ou non, reste un risque (le terme anglais exsact est «liability»), et le code de tests n’échappe pas à cette règle.
Il y autre chose que je trouve irritant et contre-productif, c’est cette règle qu’on s’est mise, et qui oblige à rouler les tests avant de pouvoir commiter. Je pense qu’il faudrait envisager au contraire de
Découpler les tests du cycle de développement
En liant les tests et leur état au cycle de développement, on s’ajoute un handicap, qui se traduit par une pénalité temporelle et cognitive sur le développement. Sur papier, cette règle fait sens, car en échange, elle oblige à avoir une assurance qualité minimale avant de pousser du code. Cela dit la couverture de test me semble de plus en plus comme une illusion, une fausse confiance dans le comportement du code.
Combien de fois ai-je vu des tests qui testaient des comportements strictement impossibles à avoir dans le fonctionnement normal de l’application, mais qui pourtant faisaient grimper le pourcentage de couverture ? Combien de fois a-t-on trouvé des bugs malgré un pourcentage enviable de couverture de tests ? Se baser sur un seul indicateur pour juger d’un aspect qualitatif est rarement une bonne idée, car cela entraine des effets de désalignement qui n’ont pas attendu la popularisation de l’IA pour se manisfester dans notre méthodologie.
Je crois en effet que seuls des tests de haut-niveau exhaustifs peuvent déclencher des flux d’execution bas-niveau pertinents, et ils doivent donc driver les tests. Or ce n’est pas ce qui se passe quand on écrit les tests à partir du bas de la pyramide par une analyse statique (par LLM ou non) du code.
Découpler l’éxecution des tests du cycle de développement permet donc de rouler des batches de tests plus lents plus fréquemment, à intervalles réguliers, et permet d’attraper non seulement les bugs liés au code, mais aussi ceux créés par les états de jeux de données, ou par tout autre changement de contexte logiciel (par exemple une expiration de certificat, une désynchromisation d’horloges, un serveur qui ne fonctionne plus ou qui a changé de contrat d’API, etc).
Vous commencez doucement à voir où je veux en venir. Plus ça va et plus je me demande s’il ne faudrait pas tout simplement
Renverser la pyramide des tests
Pas besoin de rappel, tout le monde connaît la pyramide des tests,
(Mais parce que je suis gentil, je le fais quand même 🙂 En gros on a «au sommet» les tests End-to-End, qui sont réputés coûteux et lents, donc on en fait le moins possible, en dessous on a les tests d’API ou de contrats, qui sont a peine mieux logés, ensuite on a les tests d’intégration qui sont supposés tester les interactions des composants entre eux, (et tout ce qu’on ne teste pas est mocké), qui sont encore plus abondants, et enfin le bas peuple des tests unitaires, les plus abondants, qui doivent tester les unités de code (whatever ce que ça veut dire).
Déjà, laissez-moi mettre les pieds dans le plat en disant que les deux premiers étages de la pyramide (et 80% de celle-ci), les tests d’intégration et les tests unitaires me semblent majoritairement inutiles.
En effet les tests unitaires servent à tester une fonction, ou à la limite un composant en isolation totale des autres. Sauf que quand vous faites la moindre modification dans le code d’un composant, dans les faits, que va-t-il se passer ? Les tests correspondant au code avant vos modifications vont échouer, et vous allez juste demander à votre assistant de code de les modifier en fonction de votre nouveau code. Donc en gros à quoi ça a servi au final ? Votre de code de tests a juste servi à détecter les modifications que vous avez faites, ce qu’un simple git diff vous aurait permis de connaître. On pourrait penser que les tests unitaires servent à s’assurer que les refactorings que vous faites ne «cassent» pas le comportement de votre composant….sauf que normalement ceci peut être vérifié par vos tests haut-niveau, comme vos tests E2E ou d’API si c’est juste sur le backend. Et si vous modifiez le comportement d’un composant (sans que ce soit un refactoring) mais que ça ne se «voit» pas au miveau de l’utilisateur, alors à quoi sert votre composant, au juste ?
Même chose pour les tests d’intégration, sauf que ceux-ci sont encore plus ennuyants à mettre en place, car vous devez mocker les composants dont vous ne voulez pas tester les interactions avec votre composant testé, et imaginer un état de l’application d’une façon qui soit, au choix, experte ou bullshit (je sais que vous ne codez pas full stateless, n’essayez pas de m’embrouiller). Vous devez également souvent provisionner des données, dont les modèles peuvent également changer et briser des tests qui ont peu rapport avec vos modifications.
Bref, selon moi il faudrait avoir énormement de tests haut niveau, et très peu voire aucun des tests bas niveau que sont les tests d’intégration et les tests unitaires. En d’autres termes se concentrer uniquement sur les tests qui «sont dans la lumière», c’est-à-dire qui ont un effet concret sur ce qu’on peut constater en utilisant l’API (que ce soit par son UI ou son API)
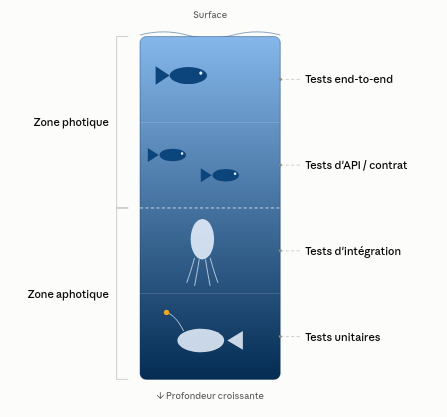
Mais du coup, comment fait-on pour avoir plein de tests de haut niveau alors qu’on nous a répété partout qu’ils sont coûteux à créer et maintenir, et qu’en plus ils prennent du temps à exécuter ?
Pour revenir à la blagounette
Je me suis demandé comment on pourrait avoir un outil, qui permettrait d’avoir une grande quantité de tests haut-niveau, qui permettrait de rouler les tests n’importe quand, (voire de façon continue), et qui automatiserait grandement la création et la maintenance des tests, comme l’aurait fait une vraie annotation @Autotest. J’ai donc commencé à coder en 2018 ce qui deviendrait, des années plus tard, la plateforme Yesbot.
Yesbot est passé par plusieurs cycles itératifs de design et de re-design, et au contraire de l’esprit de la blague originale, a pris au fil du temps le parti d’une approche la moins intrusive possible. Yesbot permet différents niveaux de configuration, mais la plus basique permet, grâce un système de proxy dédié, de l’utiliser en modifiant une seule ligne de configuration dans le front-end, et rien dans le backend. La seule exigence est que les échanges se fassent en JSON sur http (REST OU GRAPHQL), mais le support d’autres protocoles est prévu. Pour les fonctionnalités avancées, des niveaux de configuration sont nécessaires.
L’idée à terme de Yesbot est de supporter tous les types de tests haut niveau (UI et API), le tout dans une seule plateforme. Yesbot cherche également à offrir le plus d’indépendance possible, avec par exemple la possibilité d’exécuter le serveur de tests sur un host on-promise ou cloud, si les gens veulent avoir la responsabilité complète de la confidentialité de leurs données de tests.
La plateforme Yesbot est en plein développement, et cherche tout type de retour, voire de personnes qui souhaiteraient l’utiliser (temporairement, de façon gratuite !) pour les aider sécuriser le développement de leurs projets. Contactez-moi si vous êtes curieux.se !
Conclusion
Dans cet article, j’ai expliqué comment une blague nulle a été le point de départ d’une réflexion plus large sur les tests (certes hautement biaisée, incomplète et criticable, mais c’est la mienne !). Comment des années à coder m’ont permis de remettre en cause les idées communément admises, et comment cela m’a donné envie de développer la plateforme Yesbot.
Je ne pense pas que mon approche soit la meilleure, approche possible, qu’elle est révolutioinnaire ou incriticable. Tout ce que je sais c’est que j’essaie de faire quelque chose de nouveau, pour faire en sorte qu’en tant que dev on puisse se concentrer sur ce qu’on aime faire, créer des trucs, et qu’on laisse à la machine le soin de s’occuper des tâches plates.
En ces temps de bouleversement des méthodes de développement par l’IA, je pense qu’i est plus que jamais temps de s’interroger sur une façon intelligente d’utiliser ces outils. C’est ce que Yesbot essaie de faire.
Mon but est de remettre au centre de tout le plaisir de développer, comme cela a été quand j,ai découvert cette merveilleuse activité qu’est la programmation.